Scenery
ICPC 유명 문제 Scenery 에 대한 풀이 정리
Scenery
ICPC 유명 문제 Scenery 에 대한 풀이 정리
- 문제 링크: https://www.acmicpc.net/problem/14640
- koosaga님의 Unit Scheduling 설명: PDF 다운로드
- 위 글에 나온 논문: PDF 다운로드
아래 글은 koosaga 글을 내가 이해한 부분만 정리한 것이다. (증명만 빠지고 거의 그대로다)
Forbidden Regions
Scenery 문제 풀이의 핵심이 되는 개념. 일 경우에는 항상 데드라인이 작은 일을 할당하는 것이 최적이다.
- Exchange Argument를 사용하면 쉽게 보일 수 있다.
- 어떤 시점에서 일을 하겠다고 했을 때 데드라인이 큰 일을 선택하는 것은 작은 일을 수행하는 것과 바꿀 수 있기 때문.
가 그보다 큰 경우에는 오히려 할당하지 않는 것이 유리해지는 경우가 존재한다. 이를 제어하기 위해 도입된 것이 Forbidden Regions 라고 보면 된다.
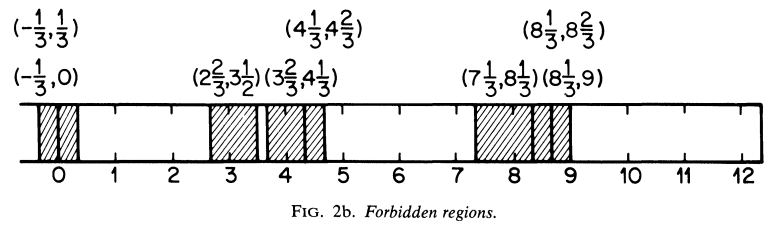
Scenery문제와 달리 논문에 나온Forbidden Regions는 딱히 정수 구간으로 제한되지 않았다…
Naiiiive한 구현
- 임의의 (모든) 와 를 고른다. (단, )
- 고른 구간 안에 속하는 모든 작업을 찾아, 아래를 수행한다.
- 부터(뒤쪽부터) 스케쥴링을 시도한다. 이 때, 이미 구해진
Forbidden Regions이 있다면 피해간다. - 스케쥴링을 한 결과는 아래 3가지 Case가 있다.
- 할당을 시도하다가 실패. 모든 케이스에 대해서 적어도 하나 이상 할당이 안되는 것을 발견한 것이므로 종료한다.
- (중요) 마지막에 할당한 가 를 만족하면, (개구간)을
Forbidden Regions에 추가한다. - 를 만족하는 경우에는
Forbidden Regions에 추가할 필요가 없다. (쉬지 않고 할당해도 된다)
- 부터(뒤쪽부터) 스케쥴링을 시도한다. 이 때, 이미 구해진
위 방법은 1번과 2번 과정부터 이미 가 되어 글러먹었다(모든 부분집합을 찾고 있는 것이므로). 다행히, 개선할 수 있다.
Polynomial Algorithm
우선, Forbidden Regions은 최대 개의 구간을 가진다. 왜냐면, 추가한 구간의 형태는 였기 때문에, 끝점의 개수는 개로 고정되고, 그들 중 최대 길이를 가지는 녀석은 1개가 되므로 전체 구간 수가 이 되는 것. 이 기본 사실을 바탕으로 연산을 아래와 같이 줄일 수 있다.
간단한 관찰을 하면, 어떤 구간 을 잡았을 때 Forbidden Region는 항상 그 구간의 왼쪽에 형성된다. 다시 말하자면, 선택한 구간 로 생성되는 Forbidden Region은 인 구간만 만들 수 있다는 것이다. 따라서 위의 Naive한 구현의 1번에서 임의의 구간을 선택하는 것이 아니라, 뒤쪽부터 선택하면서 보면 한번 처리한 후보를 다시 처리할 필요가 없어진다. 여기까지 하면 하나의 구간을 처리하는데 , 많아야 번 과정을 수행하면 되므로 시간복잡도는 이 둘을 곱해서 이다.
여기서, 구간을 가 증가하는 순으로 미리 정렬하면, 중복 계산을 제거하여 으로 만들 수 있다. 를 구간에서의 Forbidden Regions 생성 결과라고 하면, 를 알면, 마치 Mo's 알고리즘 처럼 시간만에 추가되는 녀석을 고려한 새로운 Forbidden Regions를 구할 수 있게 된다.
Deep dive Algorithm
서두에 소개된 논문에서 으로 줄일 수 있는 방법에 대해서 소개하고 있다. 아직 완전히 이해하지 못해서 적지 못하지만, 논문에서 핵심은 아래라고 한다.
The key to obtaining a speed-up from to involves a basic shift in the way we deal with critical times. Instead of keeping track of each individually, so that the current value of any can be found in constant time (the approach of Algorithm A), we shall keep track of a smaller amount of information, which will be sufficient for determining the current value of any in time . This will permit us to use more efficient procedures for organizing and updating the data structures neded for computing the values.
이전 블로그에서 옮긴 글입니다. 원래 주소